Shape

Ingénierie des Données

Catégories

Ingénierie des Données

2 article(s) dans cette catégorie

  • Ingénierie des Données

    Ingénierie des Données : Construire l'Épine Dorsale des Systèmes Axés sur les Données

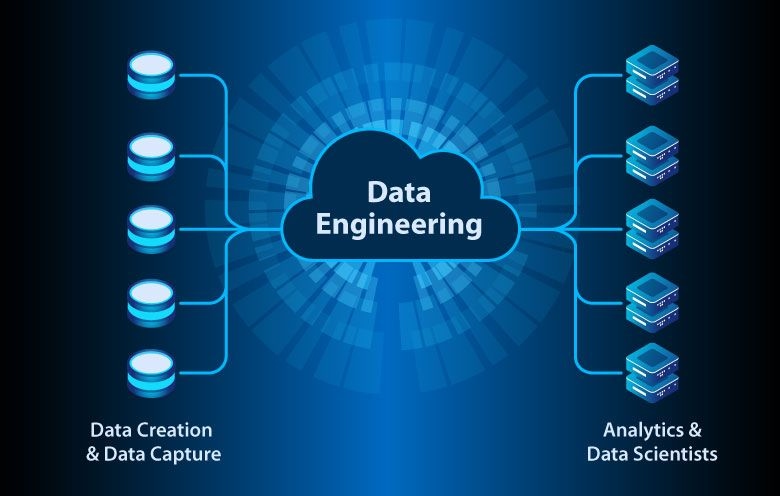
    Dans un monde inondé de données—plus de 2,5 quintillions d'octets générés quotidiennement—l'ingénierie des données est apparue comme le héros méconnu de l'ère numérique. C'est la discipline qui transforme les données brutes et chaotiques en systèmes structurés et fiables, permettant tout, de l'analyse en temps réel aux modèles de machine learning. Alors que les scientifiques des données découvrent des insights et les développeurs créent des apps orientées utilisateur, les ingénieurs de données posent les fondations, concevant des pipelines, solutions de stockage et cadres de traitement qui alimentent les organisations modernes. Cet article plonge dans le monde complexe de l'ingénierie des données, explorant ses principes fondamentaux, outils et pratiques qui alimentent le succès axé sur les données. L'Essence de l'Ingénierie des Données : L'ingénierie des données est l'art et la science de construire des systèmes robustes pour collecter, stocker, transformer et livrer des données à l'échelle. Contrairement à la science des données, qui se concentre sur l'analyse, l'ingénierie des données concerne l'infrastructure—assurant que les données sont accessibles, précises et opportunes. Imaginez une usine tentaculaire : les matières premières (données) entrent de sources comme les appareils IoT, les apps web ou les APIs ; les ingénieurs de données conçoivent les convoyeurs (pipelines), entrepôts (stockage) et chaînes de montage (traitement) pour les transformer en produits utilisables. Des entreprises comme Netflix comptent sur l'ingénierie des données pour streamer des pétaoctets de données de visionnage quotidiennement, assurant des recommandations transparentes et une disponibilité. C'est un domaine où la fiabilité l'emporte sur l'expérimentation, et l'évolutivité est reine. Pipelines de Données : Les Lignes de Vie du Flux de Données : Au cœur de l'ingénierie des données se trouvent les pipelines de données—flux de travail automatisés qui déplacent les données de la source à la destination, les transformant souvent en chemin. Ces pipelines gèrent les processus ETL (Extract, Transform, Load) : extraire les données d'un CRM comme Salesforce, les transformer en nettoyant les doublons ou normalisant les formats, et les charger dans un entrepôt de données comme Snowflake. Des outils comme Apache Airflow orchestrent ces flux de travail, planifiant les tâches et réessayant les échecs, tandis qu'Apache NiFi offre une conception visuelle de pipeline. Pour les besoins en temps réel, Apache Kafka diffuse les données instantanément—pensez à Twitter traitant des millions de tweets par minute. Un pipeline bien construit réduit la latence d'heures à secondes, mais un seul goulot d'étranglement peut arrêter net l'analyse, rendant la résilience critique. Solutions de Stockage : Où Vivent les Données : Les ingénieurs de données architecturent des systèmes de stockage pour gérer le volume, la variété et la vélocité. Les bases de données relationnelles traditionnelles (ex. : PostgreSQL) excellent pour les données structurées, mais le big data demande plus. Hadoop HDFS distribue des pétaoctets à travers des clusters, tolérant les pannes matérielles avec triple réplication. Les options cloud-natives comme Amazon S3 offrent une évolutivité infinie—stockant des objets des logs aux vidéos—tandis que Google BigQuery marie stockage et vitesse de requête pour l'analyse. Les data lakes (ex. : Delta Lake) unifient les données brutes et traitées, supportant des formats divers comme JSON ou Parquet. Choisir le bon stockage signifie équilibrer coût (S3 à 0,023$/GB/mois) avec performance (requêtes sub-seconde de BigQuery), assurant que les données sont à la fois sûres et prêtes quand nécessaire. Traitement des Données : Transformer le Brut en Raffiné : Les données brutes sont inutiles sans traitement—les ingénieurs de données manient des cadres pour les dompter. Apache Spark règne pour le lot et le streaming, traitant des téraoctets en mémoire avec ses RDDs (Resilient Distributed Datasets) ; un détaillant pourrait l'utiliser pour agréger les ventes quotidiennes à travers 10 000 magasins en minutes. Pour le temps réel, Apache Flink traite les flux d'événements avec des garanties exactement-une-fois, alimentant la détection de fraude dans les banques. Les jobs de lot pourraient s'exécuter nuitamment sur Hadoop MapReduce, bien que son approche basée disque traîne derrière la vitesse de Spark. Les services cloud comme AWS Glue automatisent ETL, tandis que dbt (data build tool) transforme les données dans l'entrepôt avec SQL. Le traitement n'est pas juste la vitesse—c'est une question de précision, car une seule mauvaise jointure peut fausser une prévision d'un million de dollars. Qualité et Gouvernance des Données : Déchets entrant, déchets sortant—l'ingénierie des données exige le contrôle qualité. Les ingénieurs implémentent des vérifications de validation (ex. : application de schéma, détection de null) et surveillance (ex. : capteurs Airflow) pour attraper les erreurs tôt. La gouvernance assure la conformité avec des lois comme le GDPR, anonymisant les PII (Informations Personnellement Identifiables) ou auditant l'accès via Apache Ranger. Des outils comme Great Expectations testent l'intégrité des données—assurant qu'un dataset de ventes ne liste pas des prix négatifs—tandis que les plateformes de métadonnées comme Apache Atlas tracent la lignée, montrant comment les données ont évolué de la source au rapport. La mauvaise qualité coûte : une étude Gartner 2021 estimait les mauvaises données à 12,9 millions de dollars annuellement pour l'entreprise moyenne. Les ingénieurs de données sont les gardiens de la confiance. Conclusion : L'ingénierie des données est le socle de l'économie des données, transformant un déluge d'octets en un flux de valeur. De la création de pipelines qui pulsent avec des données en temps réel à l'architecte de stockage qui monte en échelle sans effort, les ingénieurs de données permettent l'analyse et l'IA qui définissent notre avenir. Avec des outils comme Spark, Kafka et S3, ils affrontent la complexité de front, assurant que les données ne sont pas juste grandes mais utilisables. Alors que les organisations s'appuient plus sur les données—projetées à 181 zettaoctets d'ici 2025—le rôle de l'ingénierie des données ne fera que croître, exigeant précision, créativité et prévoyance pour garder le monde numérique bourdonnant.
    Par Sabri MAHMOUDLire l'Article Complet
  • Ingénierie des Données

    L'Importance de la Gestion des Pipelines de Données

    L'Importance de la Gestion des Pipelines de Données Dans l'ère numérique d'aujourd'hui, les données sont devenues l'un des actifs les plus précieux pour les entreprises de toutes tailles. Cependant, collecter des données ne suffit pas à générer de la valeur. Pour transformer efficacement les données brutes en insights actionnables, les organisations ont besoin de processus robustes et fiables pour déplacer, transformer et analyser ces données. C'est là qu'intervient la gestion des pipelines de données, un élément fondamental de toute stratégie moderne axée sur les données. Qu'est-ce qu'un Pipeline de Données ? Un pipeline de données est un ensemble de processus et d'outils qui permettent le mouvement des données de diverses sources vers des destinations où elles peuvent être stockées et analysées. Ces pipelines automatisent le flux de données à travers différentes étapes de traitement, assurant que les données sont collectées, nettoyées, transformées et chargées de manière cohérente et fiable. Un pipeline de données typique comprend plusieurs composants essentiels : Extraction : Collecter des données de diverses sources (bases de données, APIs, fichiers de logs, capteurs IoT, etc.) Transformation : Nettoyer, enrichir et convertir les données dans un format adapté à l'analyse Chargement : Stocker les données transformées dans un entrepôt de données, un data lake ou une autre destination Orchestration : Coordonner et planifier les différentes étapes du pipeline Surveillance : Suivre la performance et la fiabilité du pipeline Pourquoi la Gestion des Pipelines de Données est Cruciale ? 1. Assurer la Qualité et la Fiabilité des Données La qualité des données est essentielle pour prendre des décisions éclairées. Les pipelines de données bien gérés incluent des mécanismes de validation et de nettoyage qui identifient et corrigent les anomalies, doublons et incohérences. En établissant des contrôles de qualité à chaque étape du pipeline, les organisations peuvent s'assurer que les données atteignant leurs systèmes analytiques sont précises et fiables. Par exemple, une entreprise de commerce électronique analysant le comportement d'achat doit s'assurer que les données de transaction sont complètes et cohérentes avant de les utiliser pour des recommandations de produits. Un pipeline de données bien conçu peut automatiquement détecter et corriger les enregistrements incomplets ou les valeurs aberrantes, améliorant ainsi la précision des analyses ultérieures. 2. Améliorer l'Efficacité Opérationnelle Automatiser les flux de données élimine les processus manuels sujets aux erreurs et chronophages. Les pipelines de données modernes peuvent être planifiés pour s'exécuter à des intervalles spécifiques ou déclenchés par des événements particuliers, réduisant le besoin d'intervention humaine. Cette automatisation permet aux équipes de données de se concentrer sur des tâches à plus haute valeur ajoutée, telles que l'analyse et l'interprétation des données, plutôt que sur des activités répétitives de mouvement et transformation des données. De plus, les pipelines bien conçus peuvent s'adapter pour gérer des volumes de données croissants sans nécessiter des ressources supplémentaires proportionnelles. 3. Permettre la Prise de Décision en Temps Réel Dans un environnement commercial de plus en plus dynamique, la capacité à prendre des décisions basées sur les données les plus récentes peut offrir un avantage concurrentiel significatif. Les pipelines de données modernes, en particulier ceux conçus pour le traitement en temps réel, permettent aux organisations d'analyser les données au moment où elles sont générées. Par exemple, une plateforme de streaming vidéo peut utiliser des pipelines de données en temps réel pour analyser les habitudes de visionnage des utilisateurs et ajuster instantanément les recommandations de contenu. De même, une institution financière peut détecter et prévenir les transactions frauduleuses en analysant les modèles comportementaux en temps réel. 4. Assurer la Conformité et la Gouvernance des Données Avec l'essor des réglementations sur la protection des données comme le GDPR en Europe ou le CCPA en Californie, les organisations doivent être capables de suivre et documenter comment les données sont collectées, traitées et utilisées. Les pipelines de données bien gérés fournissent une traçabilité complète, permettant aux entreprises de démontrer leur conformité aux exigences réglementaires. Les pipelines peuvent être configurés pour appliquer automatiquement les politiques de gouvernance des données, telles que l'anonymisation des informations personnelles sensibles ou la mise en œuvre de contrôles d'accès basés sur les rôles. Cette approche proactive de la gouvernance des données réduit le risque de violations de conformité et renforce la confiance des clients. 5. Favoriser l'Innovation et la Croissance Des pipelines de données efficaces permettent aux organisations d'exploiter pleinement le potentiel de leurs données pour l'innovation. En rendant les données accessibles et utilisables, ils facilitent le développement de nouveaux produits, services et modèles commerciaux basés sur les insights générés. Par exemple, une compagnie d'assurance peut analyser les données de conduite pour développer des polices d'assurance personnalisées basées sur le comportement réel du conducteur. Un fabricant peut utiliser les données des capteurs pour optimiser les processus de production et réduire les coûts. Ces innovations sont rendues possibles par des pipelines de données qui fournissent un accès fiable et opportun à l'information pertinente. Bonnes Pratiques pour la Gestion des Pipelines de Données 1. Adopter une Architecture Modulaire Les pipelines de données doivent être conçus avec une architecture modulaire qui permet de modifier ou remplacer des composants individuels sans perturber l'ensemble du système. Cette approche simplifie la maintenance et l'évolution du pipeline au fil du temps à mesure que les besoins métier et les technologies changent. 2. Mettre en Œuvre une Surveillance Proactive La surveillance continue des pipelines de données est essentielle pour identifier et résoudre rapidement les problèmes potentiels. Les outils de surveillance automatisés peuvent alerter les équipes sur des anomalies telles que des retards dans le traitement des données, des taux d'erreur élevés ou des goulots d'étranglement de performance. 3. Documenter et Versionner les Pipelines Une documentation complète est cruciale pour la maintenance et l'évolution des pipelines de données, en particulier dans les grandes organisations où plusieurs équipes peuvent être impliquées. La documentation doit inclure des détails sur les sources de données, les transformations appliquées, les règles de validation et les dépendances entre les composants. 4. Prioriser la Sécurité à Chaque Étape La sécurité des données doit être une considération primordiale dans la conception et la gestion des pipelines de données. Cela inclut le chiffrement des données en transit et au repos, la mise en œuvre de contrôles d'accès stricts et l'audit régulier des activités du pipeline. 5. Planifier l'Évolutivité À mesure que le volume, la variété et la vélocité des données augmentent, les pipelines doivent pouvoir s'adapter sans dégradation significative des performances. Cela peut impliquer l'utilisation de technologies distribuées comme Apache Spark ou Kafka, qui peuvent monter en échelle horizontalement en ajoutant plus de nœuds au cluster. Conclusion La gestion efficace des pipelines de données est devenue une pierre angulaire de toute stratégie axée sur les données réussie. En automatisant et optimisant le flux de données à travers l'organisation, les pipelines bien conçus permettent aux entreprises de transformer les données brutes en insights précieux, d'améliorer l'efficacité opérationnelle et de stimuler l'innovation. Alors que le volume et la complexité des données continuent de croître, l'importance d'une gestion robuste des pipelines de données ne fera qu'augmenter. Les organisations qui investissent dans le développement de pipelines fiables, évolutifs et sécurisés seront mieux positionnées pour exploiter pleinement le potentiel de leurs données et maintenir un avantage concurrentiel dans l'économie numérique.

    Par Sabri MAHMOUDLire l'Article Complet
Shape